التشفير من طرف إلى طرف مقابل الذكاء الاصطناعي: هل يمكن للمراسلات المشفرة ومساعدي الذكاء الاصطناعي التعايش معاً؟
تتسابق كل منصات المراسلة الكبرى لإضافة ميزات الذكاء الاصطناعي، بينما يطرح كل فريق أمني جاد السؤال المقلق نفسه: إذا كان بإمكان مساعد الذكاء الاصطناعي قراءة رسائلك لتلخيصها أو ترجمتها أو البحث فيها، فهل تظل تلك الرسائل مشفرة حقاً؟
هذه مسألة تتعلق بالبنية التقنية، وتعتمد الإجابة كلياً على مكان وجود نموذج الذكاء الاصطناعي بالنسبة لحدود التشفير.
الإجابة المختصرة
نعم، يمكن لمساعدي الذكاء الاصطناعي العمل داخل تطبيقات التشفير من طرف إلى طرف، ولكن فقط إذا كان نموذج الذكاء الاصطناعي يعمل على الجهاز نفسه، داخل نطاق الثقة نفسه الخاص بالتشفير، دون أن تغادر أي بيانات نصية واضحة الجهاز للوصول إلى نموذج سحابي.
في اللحظة التي يتم فيها فك تشفير الرسالة على خادم ما — حتى لو كان ذلك لفترة وجيزة، وحتى لو تم بواسطة الذكاء الاصطناعي "الخاص بك" — فإن النظام لم يعد مشفراً من طرف إلى طرف بأي معنى حقيقي. إنه مجرد تشفير أثناء النقل إلى نقطة معالجة، وهو ما يمثل ضماناً أمنياً مختلفاً تماماً.
هذا التمييز هو جوهر الموضوع. دعنا نوضح السبب.
تذكير سريع: ما الذي يعد به التشفير من طرف إلى طرف حقاً؟
قبل الخوض في معضلة الذكاء الاصطناعي، من الضروري أن نكون دقيقين بشأن ما يضمنه التشفير من طرف إلى طرف (E2EE)، لأن الكثير من اللبس في هذا النقاش ينبع من استخدام الناس لمصطلح "مشفر" بشكل فضفاض.
التشفير من طرف إلى طرف يعني أن الرسالة يتم تشفيرها على جهاز المرسل ولا يتم فك تشفيرها إلا على جهاز المستلم. المفاتيح المطلوبة لفك التشفير لا تغادر هذين الطرفين أبداً.
يختلف هذا عن "التشفير أثناء النقل"، الذي يحمي البيانات أثناء انتقالها بين الجهاز والخادم ولكنه يتركها مكشوفة — كنص واضح — بمجرد وصولها إلى ذلك الخادم. كما يختلف عن "التشفير في حالة السكون"، الذي يحمي البيانات المخزنة ولكنه لا يضمن شيئاً بشأن من يمكنه الوصول إليها أثناء معالجتها.
لقد ساهمت منصة Signal، والمنصات المبنية على بروتوكولات مشابهة، في ترسيخ فكرة أن مزود خدمة المراسلة يجب أن يكون عاجزاً تقنياً عن قراءة رسائلك، لا أن يكتفي بتقديم وعود تعاقدية بعدم القيام بذلك. هذا هو المعيار. وأي ميزة تعيد إدخال نقطة وجود بيانات نصية واضحة خارج جهازي المرسل والمستلم تعد تراجعاً عن هذا المعيار، بغض النظر عن كيفية تسويق هذه الميزة.
هذا هو السبب الدقيق وراء خلق مساعدي الذكاء الاصطناعي لهذا التوتر. فمعظم ميزات الذكاء الاصطناعي هي، بحكم تصميمها، طرف ثالث يتم إقحامه في المحادثة لقراءة المحتوى أو تلخيصه أو التعامل معه.
لا تكمن المسألة في حسن نوايا الطرف الثالث، بل في ما إذا كان يمتلك تقنياً القدرة على الوصول إلى البيانات بصيغتها الواضحة (plaintext) أم لا.
لماذا يبدو مصطلح "الذكاء الاصطناعي داخل التشفير من طرف إلى طرف" متناقضاً
يوجد التشفير من طرف إلى طرف لضمان أمر واحد محدد: ألا يقرأ الرسالة سوى المرسل والمستلم المقصود. لا المنصة، ولا مزود الخدمة السحابية، ولا مذكرات الاستدعاء الحكومية، ولا أي شخص من داخل المؤسسة. لا أحد في المنتصف.
تعمل معظم مساعدات الذكاء الاصطناعي — مثل Meta AI داخل واتساب، وCopilot داخل Teams، وGemini داخل Gmail — عن طريق إرسال محتواك إلى نموذج سحابي لمعالجته. يحتاج هذا النموذج إلى البيانات بصيغتها الواضحة ليتمكن من إنشاء ملخص، أو الإجابة على سؤال، أو صياغة رد.
لذا، في مرحلة ما من مسار المعالجة، يتم فك تشفير رسالتك "المشفرة"، وإرسالها إلى خادم لمعالجتها، ثم إرسال النتيجة إليك.
ولهذا السبب حذر باحثو الخصوصية من أن ميزات الذكاء الاصطناعي في التطبيقات المشفرة تمثل توسعاً كبيراً في نطاق الثغرات الأمنية وفي بعض البنى التحتية، تعتبر باباً خلفياً فعلياً: فالتشفير حقيقي أثناء نقل الرسالة، ولكن بمجرد تفعيل ميزة الذكاء الاصطناعي السحابية، تصبح البيانات واضحة في مكان لم تكن فيه من قبل، سواء على خادم، أو في سجلات، أو في مسارات التدريب، أو ضمن فترة الاحتفاظ بالبيانات لدى المزود.
بالنسبة لمستخدم عادي يتحدث مع صديق، قد يكون هذا المقايضة مقبولة. أما بالنسبة لوزارة حكومية، أو وكالة دفاع، أو بنك خاضع للرقابة، أو مشغل بنية تحتية حيوية، فهذا ليس مقايضة على الإطلاق، بل هو إخفاق في الامتثال ومخاطرة بالأمن القومي.
البيانات الكامنة وراء الجدل
يظهر التوتر بين تبني الذكاء الاصطناعي وضمانات التشفير في قرارات ملموسة تتعلق بالمنتجات وفي أنشطة تنظيمية تجري حالياً:
- في مايو 2026، وسعت شركة Meta بنية المعالجة الخاصة — التي تعمل منذ أبريل 2025 — لتطلق دردشة التصفح المتخفي مع Meta AI، وهي وضع محادثة خاص ومؤقت بالكامل تؤكد Meta أنها لا تستطيع الوصول إليه بنفسها. هذا توسع ملموس في النطاق وليس بنية جديدة، ومن الجدير بالذكر أن Meta قدمته كخطوة لتمديد وعد الخصوصية الذي قطعه واتساب منذ عقد ليشمل محادثات الذكاء الاصطناعي ذاتها، وليس فقط تلخيص الرسائل. ومع ذلك، يظل هذا الخيار اختيارياً ومنفصلاً عن تجربة Meta AI القياسية، التي تستمر في المرور عبر البنية التحتية العادية وغير السرية لشركة Meta بشكل افتراضي.
- في 2 أغسطس 2026، أصبحت التزامات الشفافية المنصوص عليها في المادة 50 من قانون الذكاء الاصطناعي للاتحاد الأوروبي سارية المفعول — بغض النظر عن الجدول الزمني للامتثال عالي المخاطر الذي أرجأه قانون "ديجيتال أومنيبوس" إلى ديسمبر 2027. إن توجيهات المفوضية الأوروبية نفسها تؤكد أن هذه الواجبات تنطبق على أي نظام ذكاء اصطناعي يتفاعل مباشرة مع المستخدمين، بغض النظر عن تصنيف المخاطر، حيث أصبحت السلطات الوطنية الآن مخولة بفرض غرامات على الانتهاكات تصل إلى 15 مليون يورو أو 3% من إجمالي الإيرادات العالمية. أي ميزة ذكاء اصطناعي تصل مخرجاتها إلى مستخدم في الاتحاد الأوروبي، بما في ذلك طبقات الذكاء الاصطناعي المدمجة في منصات المراسلة هذه، تقع الآن ضمن نطاق التنظيم بشكل مباشر.
- أصبحت جوجل الآن تدمج "جيمناي" (Gemini) في كل فئة مدفوعة من "جوجل وورك سبيس" (Google Workspace) دون تكلفة إضافية، مما يعني أن الوصول إلى الذكاء الاصطناعي داخل "جي ميل" (Gmail) و"المستندات" (Docs) و"جداول البيانات" (Sheets) أصبح فعلياً ميزة افتراضية بدلاً من كونه خياراً يتطلب تفعيلاً لمئات الملايين من مستخدمي "وورك سبيس". قامت مايكروسوفت بإعادة هيكلة "مايكروسوفت 365 كوبايلوت" (Microsoft 365 Copilot) في يوليو 2026، حيث نقلته من كونه إضافة مستقلة لكل مستخدم إلى خطط مجمعة ضمن الفئات الأعلى، مما يدفع به في نفس اتجاه التفعيل الافتراضي.
- انتقلت هيئات حماية البيانات الأوروبية من التعليقات العامة إلى تقديم توجيهات محددة بشأن معالجة الذكاء الاصطناعي للاتصالات: نشرت الوكالة الإسبانية لحماية البيانات (AEPD) مبادئ توجيهية مفصلة حول الذكاء الاصطناعي الوكيل في فبراير 2026، وحددت هيئة حماية البيانات الهولندية (Autoriteit Persoonsgegevens) الرقابة على الذكاء الاصطناعي كأولوية إشرافية أساسية لعام 2026، و وجهت هيئة حماية البيانات الإيطالية (Garante) تحذيراً رسمياً لشركة ناشئة في مجال الذكاء الاصطناعي في مكان العمل بشأن أداة تحلل اتصالات الموظفين لاستنتاج حالتهم العاطفية، وهو سابقة مباشرة للتدقيق في أنظمة الذكاء الاصطناعي التي تعالج محتوى الرسائل.
- عارض مجلس حماية البيانات الأوروبي (EDPB) بشكل منفصل و متكرر مقترحات الاتحاد الأوروبي التي تتطلب فحص الرسائل المشفرة للكشف عن المحتوى، بحجة أن مثل هذه التفويضات تقوض نموذج الأمان للخدمات المشفرة من الطرف إلى الطرف، وهي نفس الحجة الهيكلية التي تنطبق على أي ميزة ذكاء اصطناعي تتطلب الوصول إلى النص الصريح.
لا يعني أي من هذا ضرورة تباطؤ تبني الذكاء الاصطناعي. بل يعني أن قرار البنية التحتية — سواء كان ذكاءً اصطناعياً سحابياً، أو ذكاءً اصطناعياً يعتمد على الحوسبة السرية، أو ذكاءً اصطناعياً يعمل بالكامل على الجهاز — لم يعد تفصيلاً تقنياً ثانوياً. بل أصبح مسألة حوكمة على مستوى مجلس الإدارة لأي مؤسسة تتعامل مع اتصالات حساسة.
كيف تتعامل المنصات الرئيسية مع هذا الأمر فعلياً
من الجدير بالنظر في كيفية تعامل الصناعة مع هذا الأمر حتى الآن، لأن النمط ثابت: تُضاف قدرات الذكاء الاصطناعي أولاً، ثم تُعدل بنية الخصوصية لتناسبها لاحقاً، مع درجات متفاوتة من النجاح.
الذكاء الاصطناعي الموجه سحابياً كخيار افتراضي
يعمل "ميتا إيه آي" (Meta AI) القياسي داخل "واتساب" — وهو الإصدار الذي يتفاعل معه معظم مستخدميه البالغ عددهم المليارات — على قناة منفصلة غير مشفرة من الطرف إلى الطرف بعيداً عن الدردشات الشخصية.
يتم معالجة المحتوى الذي تتم مشاركته معه، أو الرسائل التي يُطلب منه تلخيصها، على البنية التحتية القياسية لشركة "ميتا". تحرص "ميتا" على الإشارة إلى هذا التمييز في وثائقها، ولكن من السهل على المستخدم العادي، ناهيك عن المسؤول الحكومي أو مسؤول الامتثال، أن يغفل عنه في الاستخدام اليومي.
النتيجة الوظيفية هي التطبيق نفسه، والعلامة التجارية نفسها، لكن بوضعي أمان مختلفين تماماً جنباً إلى جنب.
الحوسبة السرية كمسار وسط ناشئ
تمثل بنية المعالجة الخاصة (Private Processing) من ميتا، وميزة الدردشة المتخفية (Incognito Chat) مع Meta AI المبنية عليها، نهجاً مختلفاً حقاً: فبدلاً من معالجة الطلبات على خوادم قياسية، يتم تشغيلها داخل بيئات تنفيذ موثوقة (Trusted Execution Environments) — وهي مناطق معزولة برمجياً تعتمد على أجهزة متخصصة وتستخدم أجهزة افتراضية سرية، بحيث لا يمكن حتى للبنية التحتية وموظفي ميتا الوصول إلى البيانات التي تتم معالجتها.
تعد هذه البنية أقوى بشكل ملموس من الذكاء الاصطناعي السحابي التقليدي، وهي مؤشر مفيد على أن أكبر المنصات تدرك أن الاعتماد الكلي على الذكاء الاصطناعي السحابي يمثل مخاطرة تستحق إيجاد حلول هندسية لتجاوزها.
ميتا نشرت ورقة تقنية بيضاء حول هذا التصميم، وهو أمر جدير بالملاحظة بحد ذاته، فمعظم الموردين لا يفتحون بنية الذكاء الاصطناعي الخاصة بهم لهذا المستوى من التدقيق. ومع ذلك، لا تزال هذه العملية معالجة سحابية تعتمد على سلامة الأجهزة المتخصصة وعلى تنفيذ ميتا لها، وهي موجودة حالياً كطبقة اختيارية بجانب التجربة الافتراضية بدلاً من كونها المعيار المعتمد على مستوى المنصة بالكامل.
النماذج الهجينة (على الجهاز/السحابية)
تعد ميزة الحوسبة السحابية الخاصة (Private Cloud Compute) من أبل محاولة مماثلة لإيجاد مسار وسط: حيث تحاول "ذكاء أبل" (Apple Intelligence) معالجة الطلبات على الجهاز أولاً، ولا يتم توجيهها إلى خوادم أبل السحابية — وفق بنية مصممة للحد من الاحتفاظ بالبيانات والوصول إليها، ومُتحقق منها عبر تدابير شفافية معلنة — إلا للاستعلامات التي تتجاوز قدرة النموذج الموجود على الجهاز.
يعكس هذا جهداً هندسياً حقيقياً نحو الخصوصية. لكنه يظل نموذجاً هجيناً: فالحاجز بين "المعالجة محلياً" و"الإرسال إلى السحابة" يتغير بناءً على تعقيد الاستعلام، وأجهزة المستخدم، وسياسة أبل نفسها — وهي أمور لا يمكن لأي فريق أمني خارجي تدقيقها أو التحكم فيها بالكامل.
مساعدو الذكاء الاصطناعي للمؤسسات المدمجون في أدوات التعاون المشفرة
يتطلب كل من Microsoft 365 Copilot وGemini في Google Workspace الوصول إلى محتوى الرسائل والملفات والتقويمات لإنشاء ملخصات أو مسودات ردود. أصبح Gemini الآن مدمجاً افتراضياً في فئات Workspace المدفوعة، كما أعادت مايكروسوفت هيكلة Copilot في منتصف عام 2026 لنقله من إضافة اختيارية إلى خطط مدمجة أيضاً — مما يعني أن الوصول إلى المحتوى بواسطة الذكاء الاصطناعي أصبح بشكل متزايد هو الإعداد الافتراضي بدلاً من كونه ميزة يجب على قسم تكنولوجيا المعلومات تفعيلها يدوياً.
حتى في الحالات التي تعلن فيها المنصة الأساسية عن تشفير البيانات أثناء التخزين والنقل، تعمل طبقة الذكاء الاصطناعي عادةً بصلاحيات وصول مرتفعة تتجاوز وظيفياً الحماية التي كان من المفترض أن يوفرها التشفير، لأن ميزة الذكاء الاصطناعي تحتاج إلى البيانات بنصها الصريح لتعمل.
لا يتم تقديم أي من هذا بسخرية من قبل الموردين المعنيين — ففي معظم الحالات، يعكس هذا الصعوبة الحقيقية في تعديل قدرات الذكاء الاصطناعي لتناسب بنية سحابية أولاً دون الإخلال بها.
لكن "صعوبة التعديل" هي بالضبط الحجة لبناء طبقة الذكاء الاصطناعي بشكل صحيح منذ البداية، بدلاً من ترقيع حماية الخصوصية حول نظام لم يُصمم للحفاظ عليها.
السؤال الحقيقي ليس "الذكاء الاصطناعي أم التشفير" — بل "أين يعمل الذكاء الاصطناعي؟"
هذا هو الإطار الذي يخطئ معظم الموردين في فهمه، لأنه يُقدم كخيار ثنائي: إما أن تحصل على ميزات الذكاء الاصطناعي، أو تحصل على تشفير حقيقي. هذا الخيار الثنائي موجود فقط لأن معظم أنظمة الذكاء الاصطناعي بُنيت لتكون سحابية في المقام الأول.
هناك خيار ثالث بدأ السوق للتو في استيعابه: تشغيل النموذج حيث توجد البيانات بنصها الصريح بالفعل وبشكل مشروع — على الجهاز نفسه، بعد فك التشفير محلياً، دون إرسال أي شيء مرة أخرى إلى الخارج.
يُشار إلى هذا أحياناً باسم الذكاء الاصطناعي الطرفي، أو الاستنتاج على الجهاز، أو الذكاء الاصطناعي المحلي أولاً. تُعد تقنية الحوسبة السحابية الخاصة من Apple ومختلف جهود نماذج اللغات الكبيرة (LLM) على الأجهزة في جميع أنحاء الصناعة خطوات أولية وجزئية في هذا الاتجاه، لكن معظمها هجين: حيث تتم معالجة بعض البيانات على الجهاز، بينما يتم توجيه البعض الآخر إلى السحابة لأي شيء يتجاوز عتبة تعقيد معينة. وهذا النموذج الهجين هو المكان الذي ينكسر فيه حاجز التشفير بهدوء.
بالنسبة للبيئات السيادية والخاضعة للتنظيم، فإن "الاعتماد على الجهاز في الغالب" ليس كافياً. يجب أن يكون المعيار بشكل قاطع على الجهاز: حيث لا يخرج نموذج الذكاء الاصطناعي، ومحرك الاستنتاج، والبيانات أبداً خارج الحدود التي صُمم التشفير لحمايتها في المقام الأول.
ما الذي يتطلبه "الذكاء الاصطناعي على الجهاز داخل حدود التشفير" فعلياً
إذا كنت تقيم ادعاء منصة ما بأن ذكاءها الاصطناعي "خاص" أو "آمن"، فهذه هي الأسئلة التقنية التي تفصل بين البنية الحقيقية ولغة التسويق:
1. أين تتم عملية الاستنتاج؟ إذا كانت الإجابة تتضمن استدعاء واجهة برمجة تطبيقات (API) لأي خادم خارجي - حتى لو كان مملوكاً لنفس المورد - فقد تم تجاوز الحدود بالفعل. يعمل الذكاء الاصطناعي الحقيقي على الجهاز محلياً على نقطة النهاية، باستخدام قدرة الحوسبة الخاصة بالجهاز (وحدة المعالجة المركزية، أو وحدة المعالجة العصبية، أو مسرع محلي خفيف الوزن).
2. هل يغادر أي نص عادي أو تضمين أو تمثيل مشتق الجهاز؟ يغفل دعاة التشفير أحياناً عن هذه النقطة: ليس نص الرسالة الخام هو المهم فحسب. فالتضمينات والملخصات وحتى البيانات الوصفية التي يتم إنشاؤها من المحتوى الذي تم فك تشفيره يمكن أن تسرب معلومات حساسة إذا تم إرسالها إلى أي مكان. النظام ذو الحلقة المغلقة الحقيقي يبقي كل ذلك محلياً.
3. هل النموذج نفسه قابل للتدقيق وسيادي؟ بالنسبة للمشترين في القطاعات الحكومية والدفاعية على وجه الخصوص، فإن عبارة "ثق بنا" ليست إجراءً أمنياً. فمن قام بتدريب النموذج، وأين تتم استضافته، وما هي الولاية القضائية التي تحكمه، وما إذا كان يمكن نشره في بيئة معزولة أو سحابة سيادية، كلها أمور تهم بقدر أهمية رياضيات التشفير.
4. ماذا يحدث عندما يحتاج الذكاء الاصطناعي إلى سياق أكثر مما يمكن للجهاز استيعابه؟ هنا تفشل معظم البنى الهجينة في الاختبار. إذا كانت الإجابة على سؤال "ماذا يحدث للاستعلامات الأكثر صعوبة" هي "يتم إرسالها إلى نموذج أكبر في السحابة"، فقد أعدت تقديم نفس التعرض الذي كان من المفترض أن يلغيه التصميم القائم على الجهاز.
الذكاء الاصطناعي على الجهاز مقابل الذكاء الاصطناعي السحابي: مقارنة جنباً إلى جنب
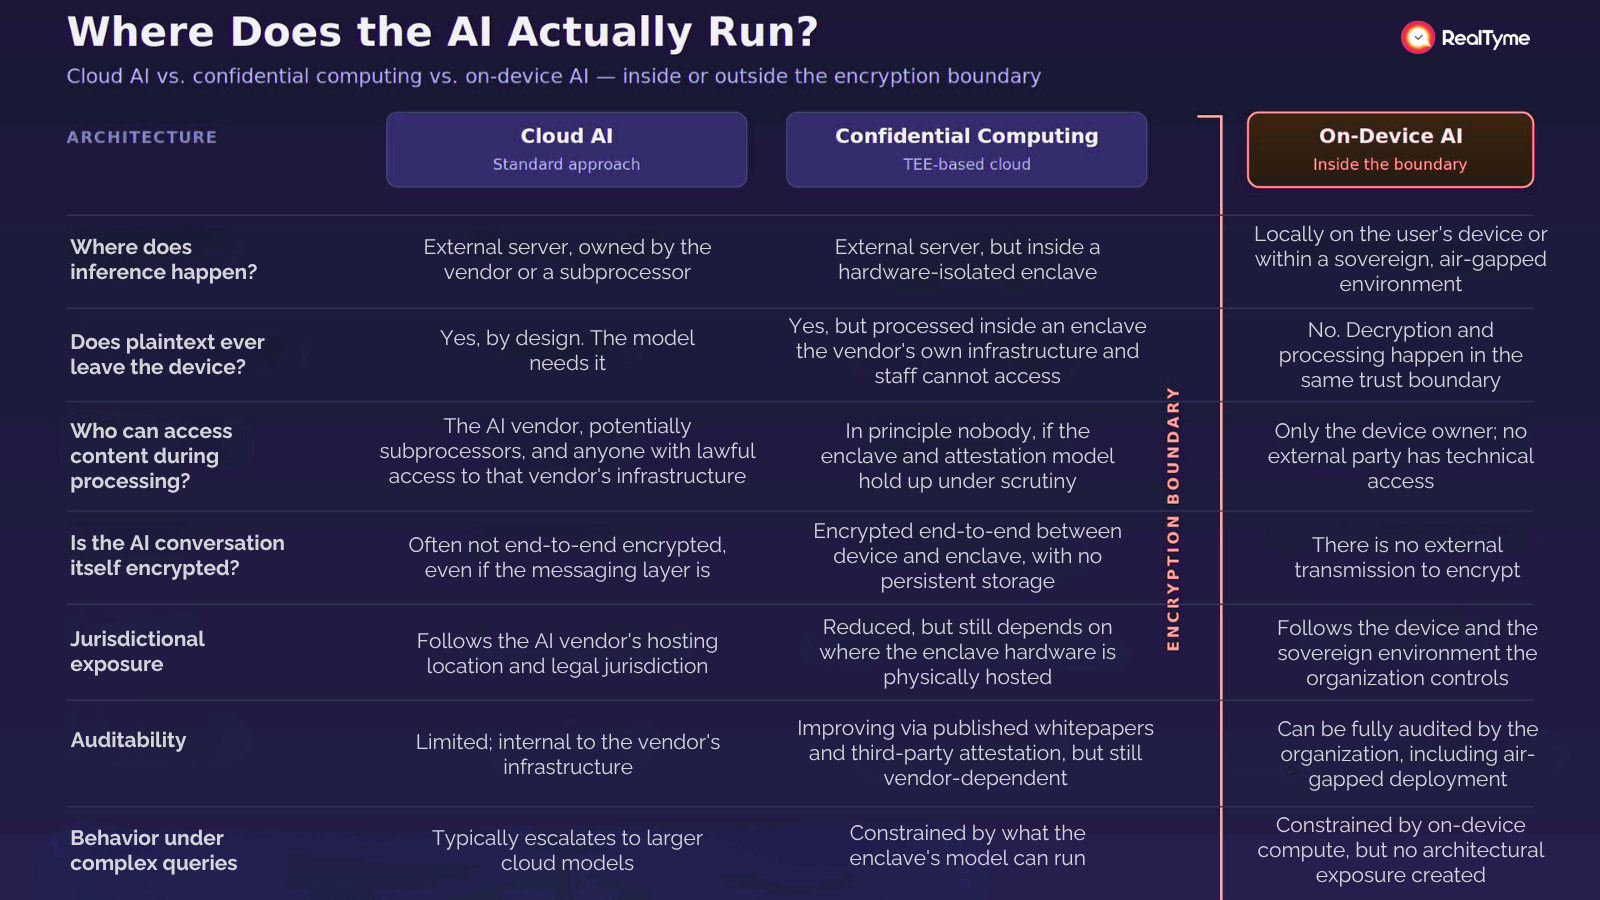
هذا الجدول هو النسخة العملية من سؤال البنية الذي يجب على كل فريق أمني أو فريق مشتريات طرحه قبل الموافقة على منصة اتصالات تدعم الذكاء الاصطناعي.
لاحظ أن الحوسبة السرية تعد تحسيناً حقيقياً مقارنة بالذكاء الاصطناعي السحابي القياسي، ولكن بالنسبة لحالات الاستخدام المصنفة أو الدفاعية أو شديدة التنظيم، فإنها لا تزال لا تضاهي ضمانات المعالجة الكاملة على الجهاز - فهي تعتمد على الثقة في أجهزة وتنفيذ مورد معين بدلاً من إزالة متطلبات الثقة تماماً.
لماذا أصبح هذا الأمر أكثر أهمية من أي وقت مضى
تتضافر ثلاث قوى لتجعل من هذا القرار المعماري ضرورة ملحة بدلاً من كونه مجرد خيار نظري:
ميزات الذكاء الاصطناعي أصبحت افتراضية وليست اختيارية
بدأت منصات المراسلة الموجهة للمستهلكين والشركات في طرح ميزات التلخيص والبحث وكتابة المسودات المدعومة بالذكاء الاصطناعي كوظائف قياسية. ومن المرجح أن المؤسسات التي لم تقم بتقييم أماكن معالجة هذه البيانات بشكل صريح قد أصبحت بالفعل عرضة للمخاطر دون اتخاذ قرار واعٍ بذلك.
الرقابة التنظيمية على تدفقات البيانات عبر الحدود تزداد حدة
أصبحت أطر العمل، مثل نظام حماية البيانات في الاتحاد الأوروبي ومتطلبات سيادة البيانات الوطنية المختلفة، تتعامل بشكل متزايد مع "المعالجة بواسطة مزود سحابة ذكاء اصطناعي أجنبي" على أنها انكشاف قضائي ذو مغزى، بغض النظر عما إذا كان النقل الأساسي مشفراً أم لا.
تهديدات "الجمع الآن وفك التشفير لاحقاً" ترفع من مستوى المخاطر المرتبطة بأي انكشاف للبيانات بنصها الصريح
في كل مرة يتم فيها فك تشفير رسالة لمعالجتها بواسطة الذكاء الاصطناعي، ولو لفترة وجيزة، فإن ذلك يخلق ثغرة لم تكن موجودة من قبل. وفي ظل مشهد تهديدات يقوم فيه الخصوم بالفعل بجمع حركة المرور المشفرة لفك تشفيرها في المستقبل، فإن تقليل كل عملية فك تشفير غير ضرورية يعد انضباطاً أمنياً وليس مجرد ميزة إضافية.
ما يعنيه هذا للمؤسسات الخاضعة للتنظيم والمؤسسات السيادية
بالنسبة للحكومات ووكالات الدفاع والشركات الخاضعة للتنظيم، فإن التوجيه العملي واضح ومباشر:
- تعامل مع أي ميزة ذكاء اصطناعي يتم توجيهها عبر السحابة داخل منصة المراسلة على أنها مسار لتسريب البيانات، وقم بتقييمها بنفس مستوى التدقيق المطبق على أي تكامل مع طرف ثالث، لأن هذا هو حقيقتها بالفعل.
- اسأل الموردين مباشرة عن مكان حدوث الاستنتاج (Inference)، وليس عما إذا كانت المنصة "آمنة" أو "مشفرة". فهذه الكلمات لم تعد تعني ما كانت تعنيه سابقاً إذا كان الذكاء الاصطناعي طرفاً في العملية.
- أعط الأولوية للمنصات التي بُنيت مع اعتماد الذكاء الاصطناعي على الحافة (Edge AI) كقرار معماري أساسي، وليس كميزة إضافية يتم دمجها فوق منتج سحابي بعد تصميمه.
- اشترط ضمانات سيادة تمتد لتشمل معالجة الذكاء الاصطناعي، وليس فقط تخزين البيانات ونقلها. فمتطلبات توطين البيانات التي لا تأخذ في الاعتبار مكان حدوث استنتاج الذكاء الاصطناعي داخل السحابة السيادية تترك ثغرة أمنية.
معايير الجودة: قائمة مراجعة المشتريات
بالنسبة للفرق التي تقيم منصات الاتصالات الآمنة المزودة بميزات الذكاء الاصطناعي، من المفيد تحويل المبادئ المعمارية المذكورة أعلاه إلى أسئلة ملموسة للمشتريات.
قبل الموافقة على أي منصة تجمع بين المراسلة والذكاء الاصطناعي، اطلب من المورد الإجابة (كتابةً، وليس عبر عرض تقديمي للمبيعات) على ما يلي:
1. أين يعمل نموذج الذكاء الاصطناعي فعلياً عند معالجة رسالة المستخدم: على الجهاز نفسه، أم في سحابة يتحكم فيها المورد، أم في بيئة سيادية يتحكم فيها العميل؟
2. هل هناك أي سيناريو يتم فيه إرسال نصوص واضحة، أو تضمينات، أو محتوى مشتق من الرسالة إلى خارج الجهاز؟ إذا كانت الإجابة نعم، فما هي الظروف، وهل يمكن تعطيل ذلك؟
3. هل يمكن تشغيل ميزة الذكاء الاصطناعي بالكامل في بيئة معزولة (air-gapped) أو داخل مقر العمل لحالات الاستخدام المصنفة أو شديدة الحساسية؟
4. ما هي المعالجات الفرعية، إن وجدت، التي يمكنها الوصول إلى المحتوى الذي تعالجه ميزة الذكاء الاصطناعي، وفي أي ولايات قضائية تعمل؟
5. هل نموذج الذكاء الاصطناعي نفسه قابل للفحص أو الاستبدال أو التشغيل بشكل مستقل عن البنية التحتية السحابية للمورد من قبل المؤسسة؟
6. ما الذي يحدث للبيانات المستخدمة لتحسين أو ضبط نموذج الذكاء الاصطناعي؟ هل يتم استخدام أي محتوى خاص بالعميل للتدريب، وهل يمكن استبعاد ذلك تعاقدياً؟
المورد الذي يمكنه الإجابة على هذه الأسئلة الستة بوضوح ودقة، قد بنى الذكاء الاصطناعي كجزء أساسي من بنيته التحتية، وليس كميزة إضافية تم دمجها لاحقاً.
المورد الذي يجيب بلغة تسويقية حول "التشفير بمستوى البنوك" دون التطرق إلى مكان حدوث المعالجة (Inference)، لم يجب على السؤال في الواقع.
نهج RealTyme: الذكاء الاصطناعي على الحافة (Edge AI)، وليس الذكاء الاصطناعي السحابي
هذه هي المشكلة التي صُممت RealTyme لحلها بالضبط. بصفتها منصة اتصالات سيادية مقرها سويسرا وتخدم الحكومات ووكالات الدفاع والمؤسسات الخاضعة للتنظيم، تنطلق RealTyme من افتراض أن أي ميزة ذكاء اصطناعي تمر عبر سحابة طرف ثالث تعد كشفاً للبيانات لم توافق عليه المؤسسة، بغض النظر عن كيفية تسويق المورد لها.
RealTyme's الذكاء الاصطناعي على الحافة (Edge AI) يعتمد هذا النهج على تشغيل الاستنتاج محلياً على الجهاز أو ضمن بيئة سيادية خاضعة لسيطرة العميل، داخل نفس نطاق الثقة الخاص بالتشفير من طرف إلى طرف للمنصة. لا يوجد خيار احتياطي هجين يقوم بتوجيه الاستعلامات المعقدة سراً إلى نموذج سحابي خارجي، كما لا توجد بيئة حوسبة سرية تعتمد أمنياً على الوثوق بتنفيذ الأجهزة الخاص بطرف ثالث.
تُعد قدرات الذكاء الاصطناعي وضمانات التشفير قراراً معمارياً واحداً، وليست نظامين تم دمجهما معاً لاحقاً. وهذا يعني إمكانية نشر الذكاء الاصطناعي على الحافة في بيئات معزولة تماماً (Air-gapped) وبيئات سرية، حيث لا يكون الذكاء الاصطناعي المعتمد على السحابة خياراً متاحاً، مهما بلغت جودة تصميمه.
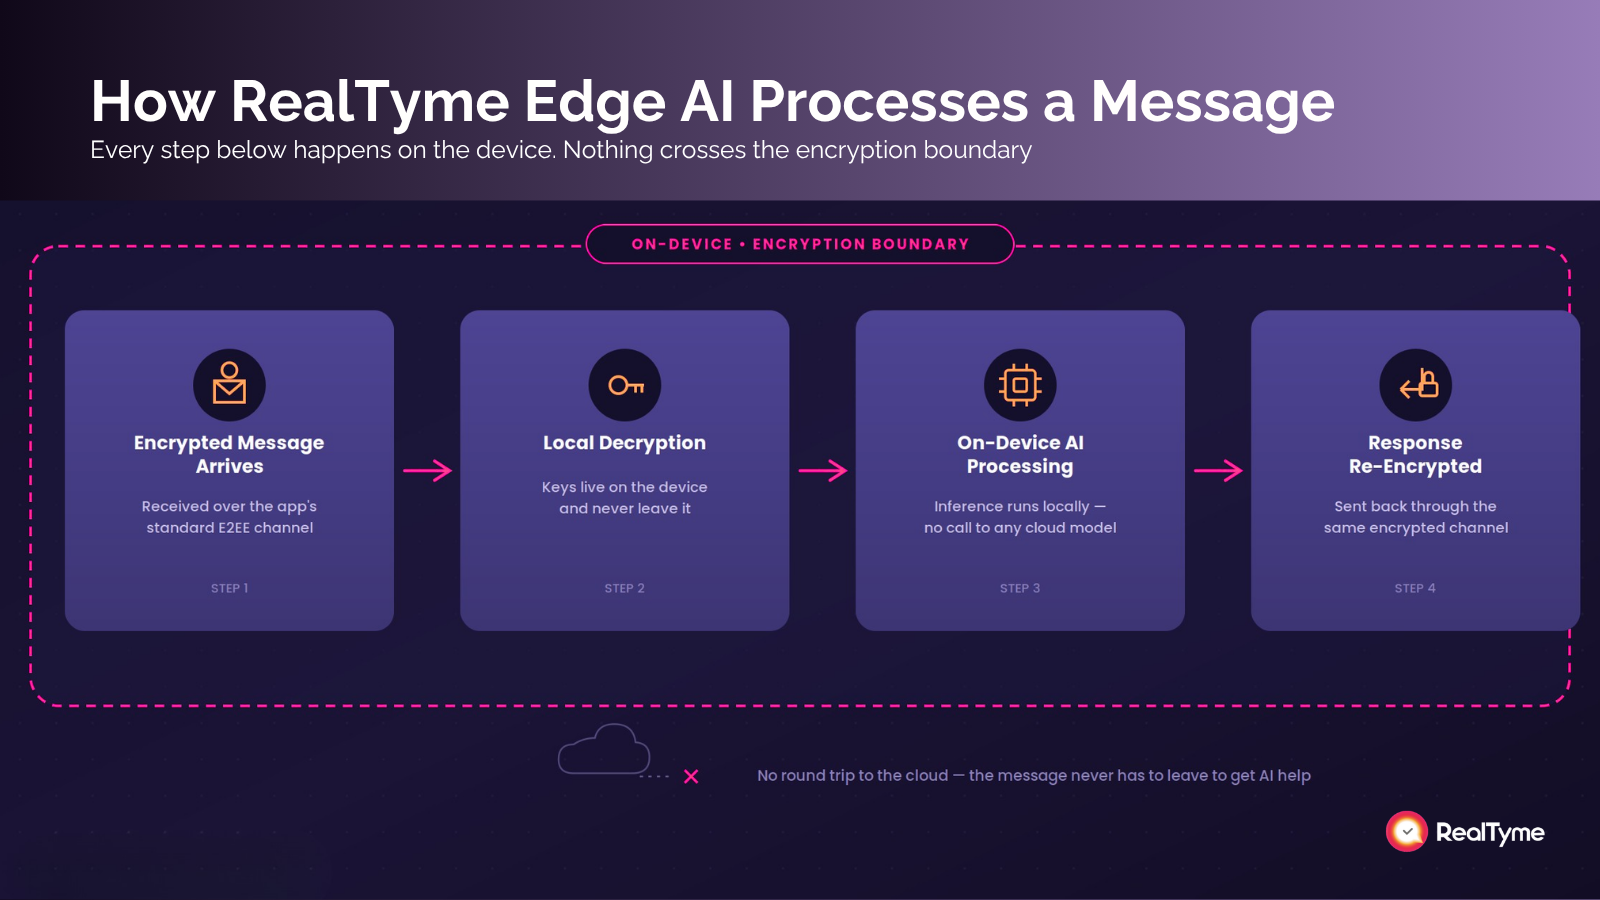
بالنسبة للمؤسسات التي تراجع قائمة متطلبات الشراء المذكورة أعلاه، يكمن الفرق هنا بين منصة مراسلة آمنة يمكنها الإجابة على الأسئلة الستة كتابةً، ومنصة أخرى تتطلب استثناءً لواحدة منها على الأقل.
الخلاصة
الذكاء الاصطناعي والتشفير من طرف إلى طرف ليسا متناقضين بطبيعتهما. يظهر التناقض فقط عندما يتم بناء الذكاء الاصطناعي بالطريقة التي تتبعها معظم الشركات في هذا القطاع: الاعتماد على السحابة أولاً، مع إضافة التشفير كطبقة خارجية بدلاً من دمجه في التصميم منذ البداية.
المنصات التي ستنال ثقة الحكومات، والمؤسسات الدفاعية، والشركات الخاضعة للتنظيم خلال السنوات القادمة هي تلك التي حلت هذه المعضلة على مستوى البنية التحتية؛ حيث لا تتنافس قدرات الذكاء الاصطناعي مع ضمانات التشفير، بل هما قرار تصميم واحد تم اتخاذه مرة واحدة وبشكل صحيح.
هذا هو مبدأ التصميم الذي يرتكز عليه نهج RealTyme في بناء الثقة والوفاء بالوعود في مجال الاتصالات السيادية.
الأسئلة الشائعة
هل يمكن لمساعدي الذكاء الاصطناعي العمل داخل تطبيقات مشفرة من طرف إلى طرف؟
نعم، ولكن فقط إذا كان نموذج الذكاء الاصطناعي يعمل بالكامل على الجهاز، داخل نفس نطاق الثقة الخاص بالتشفير نفسه. إذا تم تنفيذ أي جزء من المعالجة على خادم سحابي، فسيتم فك تشفير الرسالة فعلياً خارج جهاز المستلم، مما يكسر الضمان الأساسي للتشفير من طرف إلى طرف.
هل يمكن للذكاء الاصطناعي قراءة الرسائل المشفرة؟
فقط إذا تم فك تشفيرها أولاً. يتطلب مساعدو الذكاء الاصطناعي القائمون على السحابة الوصول إلى النصوص الواضحة ليعملوا، وهو ما توفره معظم ميزات الذكاء الاصطناعي الشائعة عن طريق فك تشفير المحتوى قبل إرساله للمعالجة. أما نموذج الذكاء الاصطناعي الذي يعمل على الجهاز فيمكنه "قراءة" الرسائل محلياً، بعد أن يقوم الجهاز بفك تشفيرها للمستخدم، دون إرسال أي شيء إلى الخارج.
هل تؤدي إضافة ميزات الذكاء الاصطناعي إلى تطبيق مراسلة إلى كسر التشفير من طرف إلى طرف؟
يعتمد الأمر كلياً على البنية التحتية. يؤدي الذكاء الاصطناعي الموجه للسحابة إلى إضعاف نموذج الأمان، حتى لو ظل تشفير النقل الأساسي سليماً، لأن النصوص الواضحة أو البيانات المشتقة تغادر القناة المشفرة.
تعمل نهج الحوسبة السرية — مثل المعالجة الخاصة من Meta في دردشة Incognito مع Meta AI في واتساب — على تقليل هذا التعرض من خلال معالجة البيانات داخل بيئات معزولة برمجياً ومادياً لا يمكن للمزود نفسه الوصول إليها، لكنها تظل معتمدة على البنية التحتية السحابية وتنفيذ المزود.
يُعد الذكاء الاصطناعي على الجهاز الذي لا ينقل أي بيانات للخارج هو النهج الوحيد الذي يحافظ على ضمان التشفير من طرف إلى طرف دون الحاجة إلى الوثوق بأجهزة طرف ثالث.
ما المقصود بالذكاء الاصطناعي على الحافة (Edge AI) في سياق الاتصالات المشفرة؟
يعني الذكاء الاصطناعي على الحافة تشغيل نماذج الذكاء الاصطناعي محلياً على الجهاز أو ضمن بيئة سيادية خاضعة للتحكم، بدلاً من توجيه البيانات إلى خدمة سحابية مركزية. وفي المراسلات المشفرة، هي البنية التي تتيح ميزات الذكاء الاصطناعي دون إعادة تعريض النصوص الواضحة للخطر، وهو ما يتطلبه الذكاء الاصطناعي القائم على السحابة.
لماذا يعد هذا الأمر مهماً للحكومات والقطاعات الخاضعة للتنظيم على وجه التحديد؟
لأنها تعمل وفق متطلبات سيادة البيانات وتصنيفها والامتثال لها، والتي تعتبر أي كشف غير مصرح به للبيانات — حتى لو كان لحظياً أو لمزود ذكاء اصطناعي "موثوق" — مخاطرة جسيمة. إن الذكاء الاصطناعي الذي يعمل على الجهاز داخل نطاق التشفير هو البنية الوحيدة التي تلبي كلاً من الحاجة إلى قدرات الذكاء الاصطناعي ومتطلبات التحكم السيادي والقابل للتدقيق.
هل يتمتع الذكاء الاصطناعي الذي يعمل على الجهاز بنفس قدرات الذكاء الاصطناعي السحابي؟
بالنسبة لمعظم المهام الشائعة — مثل التلخيص والترجمة والبحث والمساعدة في الكتابة — فقد تقلصت الفجوة بشكل كبير مع تحسن النماذج الأصغر والأكثر كفاءة. عادة ما تكون النماذج التي تعمل على الجهاز أصغر من أكبر النماذج المستضافة سحابياً، ولكن المقارنة ذات الصلة للمؤسسات التي تهتم بالأمن ليست القدرة الخام، بل هي المفاضلة بين الذكاء الاصطناعي على الجهاز وبين مخاطر توجيه الاتصالات الحساسة عبر خدمة سحابية تابعة لجهة خارجية.
كيف يمكن لفريق الأمن التحقق من ادعاءات البائع بشأن الذكاء الاصطناعي على الجهاز بدلاً من الاكتفاء بالوعود التسويقية؟
اطلب وثائق البنية التقنية، لا الكتيبات الترويجية. يجب أن يكون الذكاء الاصطناعي الحقيقي الذي يعمل على الجهاز قابلاً للإثبات من خلال تحليل حركة مرور الشبكة للتأكد من عدم وجود اتصالات خارجية أثناء معالجة الذكاء الاصطناعي، ومن خلال خيارات النشر التي تدعم البيئات المعزولة تماماً عن الإنترنت، والاستعداد لإخضاع هذه الادعاءات لتدقيق مستقل.